报表停在“发生了什么”,商业问题在“接下来做什么”
绝大多数体育媒体平台的数据系统,本质上仍是一台报表机器:按天、按周汇总播放量、观看时长、新增用户、广告填充率,然后把这些数字交给人去解读。它回答的是“发生了什么”,而运营、商务和内容负责人真正需要的,是“这件事值多少钱、该不该加码、要不要换一种变现方式”。
这中间隔着一大段人工分析:找出谁在看,把观看行为和会员订单、广告曝光、商品点击对齐,再判断增长能维持多久。从发现到形成建议通常要三到五天,而一轮季后赛的热度半衰期往往只有一两周。
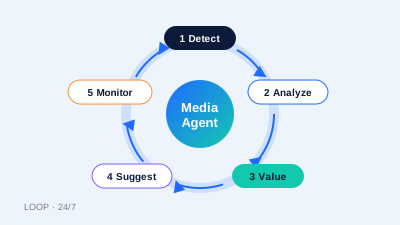
所谓Sports Media Agent,不是一个更会写周报的聊天机器人,而是一个会主动把问题问下去的分析流程:发现异常,调用合适的模型逐层拆解,把结论翻译成商业动作,并在执行后持续检查。它的价值不在替人拍板,而在把“发现信号”到“形成可审批方案”的时间从几天压缩到几个小时。
这个话题在2025—2026年变得具体:赛事方已把多Agent系统放到球迷面前,广告行业在为Agent交易起草协议,研究机构则提醒不少Agent项目会半途而废。
一个模拟场景:战术复盘短视频为什么突然涨了
以下为模拟场景,数字仅用于说明分析方法。某体育媒体平台过去8周,“赛后战术复盘”类短视频平均周播放约320万;上周达到约960万,增长约两倍。同期全站短视频播放只增长了12%。内容团队的第一反应是“这类内容火了,多做点”。
如果只看报表,这个判断很自然。但一个合格的Media Agent会追问:增长是不是集中在一两条爆款上?上周是否有一场争议判罚让所有人都在找复盘?看的人是被算法推来刷一下就走的新用户,还是活跃的老用户甚至会员?看完之后有没有去看直播、开会员、点商品?
这些答案会把“多做点”变成不同的决策:单场事件驱动的偶发热点,应该快速复用而不是扩编团队;老用户的深度需求,可以放一部分进会员区;新用户的浅层流量,也许更适合调整广告策略。
Detect → Analyze → Value → Suggest → Monitor 的五个环节
Detect:先确认这是一个值得追问的信号
异常检测模块把每一类内容的播放、时长、互动放进各自的历史基线里比较,而不是和全站平均比。它要排除三种假信号:单条视频贡献了绝大部分增量(模拟场景里前3条视频只占增量的31%,增长较分散);推荐位改版等统计口径变化;与去年同期赛程节点的重合。
Analyze:拆开看是谁在看、怎么看
Agent调用Audience Analytics,把观看者按新老用户、会员状态、主队偏好、设备和时段分组。模拟结果显示:增量播放中约58%来自注册超过6个月的老用户,其Completion Rate达到54%,明显高于平台短视频平均的29%;另外42%来自新用户,完播率只有21%,7日回访率很低。同一个“播放增长”里,藏着两种截然不同的观众。
Value:把播放翻译成三条收入线
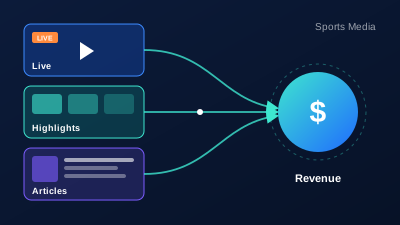
Revenue Model接手,把两组观众分别映射到广告、会员和商品三条收入线。老用户组的CPM不高,但观看后24小时内进入直播间、点击会员引导的比例都更高;新用户组贡献更多广告曝光,几乎没有会员转化。Forecast Model同时估算持续性:剔除争议判罚那一场后,老用户组的观看在过去三周持续抬升,新用户组呈典型的单峰衰减。
Suggest:给出可以被审批的动作
Recommendation Engine据此生成建议,而不是一句“建议加大投入”。模拟场景中的建议是:战术复盘周产量从10条增至14条,重点覆盖老用户关注度高的两支球队;视频第60秒后加入会员引导,指向完整版战术分析;新用户流量暂不提高广告加载,先观察两周回访;嵌入对应球员的球衣商品卡,测试点击率。
Monitor:执行后继续盯住它
建议被批准后,每一项动作绑定一个观测指标和止损阈值,例如会员引导点击率低于0.8%就回退、完播率下降超过5个百分点就撤掉商品卡。
Agent到底调用了哪些组件
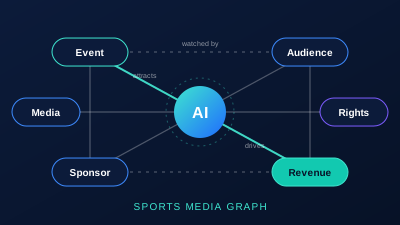
很多人想象中的Media Agent,是一个什么都懂的大模型。实际上,语言模型在这里主要负责理解问题、编排调用和把结果写成人能读懂的解释;真正的数字,来自一组各有分工的专用组件。已经上线的体育Agent产品大多也是这种结构:据IBM 2025年6月的发布,温网Match Chat由watsonx Orchestrate上的一组AI Agent配合大模型,调用实时和历史比赛数据作答;NFL Pro在2025赛季推出的Fantasy AI Assistant,由多个专门Agent分别负责数据检索、分析、洞察生成和答案汇总。它们回答球迷的问题,Media Agent回答商务团队的问题,分工逻辑一致。这也是BB体育在设计体育媒体AI时坚持的原则:会说话的模块不负责算钱,算钱的模块必须能被追溯。关于这些组件背后需要理解哪些实体和关系,可以参考体育媒体商业大模型的实体与关系。
| 环节 | 调用组件 | 输入数据 | 输出 | 是否需要人工 |
|---|---|---|---|---|
| Detect | Anomaly Detection、Content Taxonomy | 分类内容播放、时长、互动历史基线 | 异常信号及可信度 | 否,自动过滤 |
| Analyze | Audience Analytics | 用户分层、会员状态、观看行为 | 观众分组与各组完播、回访 | 否 |
| Value | Revenue Model、Forecast Model | 广告曝光与CPM、会员订单、商品点击 | 分组收入贡献与持续性估计 | 分析师抽查 |
| Suggest | Recommendation Engine、语言模型 | 前述结论与业务约束 | 动作清单、预期影响、风险说明 | 是,负责人审批 |
| Monitor | Experiment Tracker、Forecast Model | 执行后指标与对照组 | 效果评估、回退触发 | 超阈值时通知人工 |
表里最重要的一列是“输入数据”:能否在同一用户、同一内容、同一时间窗口上把播放、订单和商品点击对齐。用户ID打不通,再聪明的Agent也只能猜相关性。
人在哪里审批:三道闸门
一个反直觉的判断是:Agent越主动,人工审批的位置越要精确,而不是越少越好。每步都要人确认,Agent就退化成取数工具;完全不设闸门,它可能在一个偶发热点上烧掉一季度的内容预算。BB体育的Media Agent把人工介入集中在三类动作上。
- 预算与产能调整:增加内容产量、调整编辑人力、追加推广预算,由内容负责人批准,Agent要同时给出判断错误时的最坏损失。
- 广告加载变化:提高广告频次或改变插入位置会直接影响观看体验,需要商业化和用户体验负责人共同确认,并附带小流量实验方案。
- 对外承诺:凡是涉及广告主报价、赞助权益包装、会员权益调整的建议,Agent只能出草案,不能自动推送给客户。
除此之外,异常检测、用户分组、收入拆解和效果监测都自动运行,只在超出阈值时提醒人。
对外承诺这道闸门,接下来会更重要。2025年10月,Yahoo、PubMatic、Scope3等公司发起基于MCP的广告Agent开放标准AdCP,希望媒体购买可由Agent直接执行;一个月后IAB Tech Lab发布Agentic RTB Framework v1.0征求意见稿,两条路线并存;同年12月,MCP被捐赠给Linux基金会下的Agentic AI Foundation。体育媒体的广告库存今后可能先被买方Agent读取、比价,再轮到人工谈判。卖方Media Agent因此要把各类内容的受众分组、完播和可售库存整理成可追溯的结构化数据;报价和权益包装仍停在草案层,协议解决机器之间怎么对话,不解决库存以什么底价出售。
Agent最容易犯的三种错,以及怎么防
错误一:把季节性和偶发热点当成趋势
体育内容的流量天然有强烈的节奏:季后赛、德比、转会窗口、国家队比赛日。一个没有赛程意识的Agent,很容易在每年的同一时间“发现”同一个增长。防范方法是给Detect环节加入赛程日历和同比基线,把每个信号先和去年同期、同赛程阶段比较;同时把单场事件从样本中剔除,看剩下的部分是否仍然增长。模拟场景里,剔除争议判罚那一场后,只有老用户组的增长仍然成立。
错误二:把相关当成因果
Agent可能发现“看过战术复盘的用户,会员续费率高出20%”,然后建议多推复盘视频。但更可能的解释是:本来就忠诚的用户才会去看战术复盘。防范方法是让Revenue Model只输出相关贡献,因果判断留给实验:随机让一部分用户看到复盘推送、另一部分看不到,比较续费差异。没有对照组的结论,必须标注为“待验证”。
错误三:把播放增长直接读成收入增长
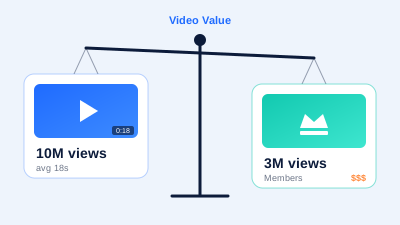
这是最隐蔽的错。新用户带来的大量播放,可能完播率很低、广告跳出率很高,甚至拉低整体CPM,和1000万播放为什么可能不如300万播放赚钱是同一个道理。防范方法是在Value环节按观众分组计算收入,并同时列出播放和收入各增长多少,差距过大时自动降低建议优先级。
从报表到Agent,组织需要先改的不是模型
很多平台引入Agent时,注意力放在选哪个模型。实际更常见的瓶颈是数据和流程:内容标签不统一,Agent分不清“战术复盘”和“赛后集锦”;广告系统只能按天出数,看不到单条视频的收入;会员订单缺少来源内容字段,Revenue Model只能粗糙归因。
另一个容易被忽视的问题是:Agent的建议需要有人接。内容、商业化和会员团队各有KPI,一条“增加复盘产量但不提高广告加载”的建议,可能让商业化团队的短期指标变差。在BB体育的分析报告里,这类冲突会被单独列出,但优先级需要组织事先约定。关于Agent如何从一个具体信号追到内容、用户、比赛和球员,另一篇文章做了更细的拆解:体育媒体Agent如何自己发现内容价值上涨。
外部环境也在提示降温。Gartner在2025年6月预测,到2027年底超过40%的Agentic AI项目会因成本上升、价值不清或风控不足而被取消;它还提醒警惕agent washing,即把普通助手、RPA或聊天机器人包装成Agent,并估计数千家自称的Agent厂商中真正具备能力的只有约130家。判断是不是真正的Media Agent,要看它能否走完Detect到Monitor的闭环、说清每个数字来自哪个组件,而不是对话界面多流畅。
上线Media Agent之前的检查清单
- 内容分类是否稳定?同一类内容过去一年的标签是否一致,能否支撑历史基线比较。
- 用户ID是否打通?播放、广告曝光、会员订单、商品点击能否落到同一个用户和同一条内容上。
- 赛程日历是否接入?Detect环节能否识别季后赛、德比、转会窗口等节点。
- 收入拆解是否按观众分组?能否分别给出新老用户、会员与非会员的贡献。
- 审批闸门是否明确?预算、广告加载、对外承诺三类动作是否都有审批人,对外输出的库存数据是否有人复核。
- 每条建议是否绑定观测指标和回退阈值?没有止损条件的建议不进入执行。
- 因果结论是否有实验支撑?没有对照组的判断是否标注为待验证。
如果七项里有三项以上还做不到,先别急着上Agent:把报表改成能按观众分组、按收入线拆解,比一个会说话的Agent更有价值。